تحلیل فایل طولانی با هوش مصنوعی؛ آیا بند مهم هزینه از قلم میافتد؟
اگر برای مقایسه دو پیشنهاد خرید، یک فایل بلند را به هوش مصنوعی میدهید، پذیرفتهشدن فایل هنوز ثابت نمیکند که همه بندهای مؤثر بر هزینه در پاسخ آمدهاند. ممکن است قیمت پایه درست استخراج شود، اما شرط تغییر قیمت، هزینه خدمات اضافی یا استثنای یک بند در جمعبندی دیده نشود. پرسش مهم برای خریدار و صاحب کسبوکار این است: مدل فقط عدد را پیدا کرده، یا آن را با تمام شرطهای مرتبط کنار هم گذاشته است؟
ظرفیت پردازش متن بلند واقعاً مفید است و مدلها در استفاده از آن پیشرفت کردهاند. بحث بر سر فاصله میان «جا گرفتن اطلاعات در ورودی» و «استفاده درست و کامل از اطلاعات» است؛ فاصلهای که باید در انتخاب ابزار و تأیید خروجی اندازه گرفت.
فهرست مطالب
- 1 پنجره زمینه بزرگ چه چیزی را تضمین میکند؟
- 2 شواهد از کجا میآیند و چه چیزی را ثابت نمیکنند؟
- 3 پاسخ منصفانه: مدلها در متن بلند پیشرفت کردهاند
- 4 چطور یک قیمت درست میتواند به مقایسه ناقص برسد؟
- 5 پیش از اعتماد به تحلیل فایل، این پنج کنترل را انجام دهید
- 6 برای خرید ابزار، ظرفیت بیشتر را با کدام معیار بسنجیم؟
- 7 پرسشهای رایج
پنجره زمینه بزرگ چه چیزی را تضمین میکند؟
پنجره زمینه یا Context Window، ظرفیت متنی است که مدل میتواند در یک نوبت پردازش در اختیار داشته باشد. این ظرفیت با توکن سنجیده میشود؛ توکن واحد پردازش متن است و الزاماً با یک کلمه یا یک صفحه برابر نیست. عدد ظرفیت، بهتنهایی نمره دقت تحلیل سند نیست.
برای بررسی یک فایل سه سؤال جدا داریم: آیا محتوای لازم از فایل در دسترس ابزار قرار گرفته است؟ آیا بخش مرتبط پیدا شده است؟ آیا مدل رابطه آن بخش با جدولها، شرطها و استثناهای دیگر را درست فهمیده است؟ پاسخ مثبت به سؤال اول، پاسخ دو سؤال بعدی را تعیین نمیکند.
همچنین نمایش نام PDF در گفتوگو، بهتنهایی مدرک استخراج بینقص تمام متنها، جدولها و تصویرهای آن نیست. پژوهشهای این مطلب عمدتاً استفاده مدل از متنِ ورودی را بررسی کردهاند؛ نباید نتایج آنها را آزمون همه روشهای خواندن PDF دانست.
شواهد از کجا میآیند و چه چیزی را ثابت نمیکنند؟
پژوهش Lost in the Middle در سال ۲۰۲۳، با جابهجاکردن محل اطلاعات در ورودی نشان داد عملکرد مدلهای آزمایششده میتواند تغییر کند. در بسیاری از آزمونها، اطلاعات ابتدای متن یا انتهای آن بهتر از اطلاعات میانه استفاده میشد. موضوع آزمایش، پاسخگویی با چند سند و بازیابی اطلاعات بود.
محدودیت مهم این است که مدلهای آن پژوهش متعلق به همان دورهاند. بنابراین نتیجه درست «محل اطلاعات میتواند در ارزیابی مهم باشد» است؛ نه اینکه همه مدلهای امروز حتماً وسط فایل را نادیده میگیرند. این مطالعه، میزان خطای بررسی یک قرارداد فارسی در ابزار فعلی شما را اندازه نگرفته است.
پژوهش RULER در سال ۲۰۲۴ نیز ۱۷ مدل را با ۱۳ وظیفه مصنوعی بررسی کرد. نتیجه کلیدی آن این بود که موفقیت نزدیک به کامل در پیدا کردن یک داده مشخص، لزوماً به همان کیفیت در کارهای پیچیدهتر، مانند دنبالکردن چند رابطه یا جمعکردن اطلاعات پراکنده، منتقل نمیشود.
خود نویسندگان RULER تأکید کردهاند ارتباط این آزمونهای مصنوعی با وظایف واقعی هنوز بهطور کافی تأیید نشده است. پس امتیاز یا «طول مؤثر» یک مدل در آن مقاله، سقف قطعی توان همه ابزارها و همه اسناد نیست.
پاسخ منصفانه: مدلها در متن بلند پیشرفت کردهاند
نادیدهگرفتن پیشرفتها هم گمراهکننده است. OpenAI در گزارش ۱۴ آوریل ۲۰۲۵ درباره GPT-4.1 از بهبود بازیابی اطلاعات در متن بلند خبر داد و در آزمون داخلی خود، پیدا کردن یک داده مشخص را در موقعیتهای مختلف تا یک میلیون توکن گزارش کرد.
همان گزارش توضیح میدهد که کار واقعی معمولاً سختتر از پیدا کردن یک پاسخ واضح است: مدل باید چند داده مرتبط را پیدا کند، تفاوتهای ظریف را تشخیص دهد و رابطه آنها را بفهمد. این سند، ارزیابی سازنده از یک مدل مشخص در سال ۲۰۲۵ است؛ نه رتبهبندی ابزارهای امروز یا تضمین بررسی بیخطای قرارداد.
بنابراین تضاد واقعی میان «AI مفید است» و «AI بیفایده است» نیست. یک ابزار میتواند در جستوجوی سند کمک بزرگی باشد، ولی برای تصمیمی که به کاملبودن بررسی وابسته است، همچنان به آزمون و تطبیق با اصل سند نیاز داشته باشد.
چطور یک قیمت درست میتواند به مقایسه ناقص برسد؟
یک مثال آموزشی را در نظر بگیرید: دو شرکت برای خدمتی مشابه پیشنهاد دادهاند. در پیشنهاد اول، قیمت پایه در ابتدای فایل آمده و هزینه پشتیبانی در پیوست است. پیشنهاد دوم قیمت بالاتری دارد، اما همان پشتیبانی را شامل میشود. اگر جمعبندی فقط قیمت پایه را کنار هم بگذارد، عددها میتوانند درست باشند و مقایسه همچنان ناقص بماند.
این سناریو، گزارش خطای واقعی یک شرکت یا نتیجه آزمایش زد ارز نیست. هدفش روشنکردن نوع کنترل موردنیاز است: «عدد را پیدا کن» با «هزینه دو گزینه را برای نیاز یکسان مقایسه کن» یک درخواست نیست. تاریخ اعتبار پیشنهاد، واحد پول، خدمات مشمول و شرط لغو هم میتوانند نتیجه را تغییر دهند.
از طرف دیگر، استخراج جزئیات با AI ممکن است زمان رسیدن به بندهای مهم را کم کند. ارزش آن را با خروجی قابلبررسی بسنجید؛ همان معیاری که در مطلب هزینه پنهان هوش مصنوعی و زمان بازبینی توضیح دادهایم.
پیش از اعتماد به تحلیل فایل، این پنج کنترل را انجام دهید
پیشنهادهای زیر، روش عملی تحریریه برای قابلبررسیکردن خروجیاند؛ تضمین حذف خطا یا دستورالعمل اثباتشده برای همه مدلها نیستند.
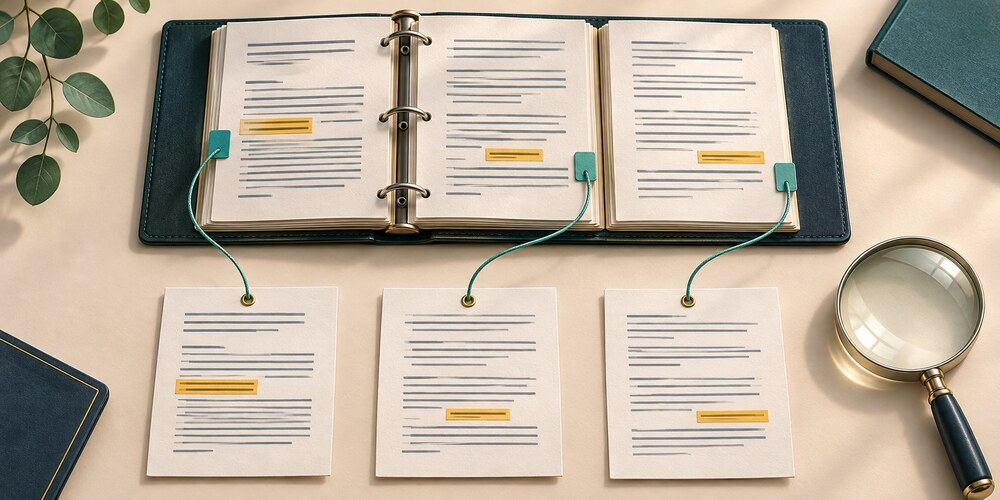
- دامنه را مشخص کنید: نام و نسخه فایل، پیوستهای موجود و سؤال دقیق را بنویسید. درباره بخش ناخوانا یا فایل مفقود، خروجی باید صریح باشد.
- فهرست اطلاعات لازم بدهید: برای مقایسه هزینه، قیمت پایه، هزینههای اضافه، تاریخ اجرا، واحد پول و استثناها را جدا بخواهید؛ نه صرفاً «یک خلاصه خوب».
- نشانی هر ادعا را بخواهید: شماره صفحه یا عنوان بخش، همراه با عبارت کوتاه پشتیبان. سپس خودتان آن نشانی و عبارت را در اصل فایل بررسی کنید؛ شماره صفحه تولیدشده هم میتواند غلط باشد.
- ارجاعها را دنبال کنید: اگر بند به پیوست یا تعریف دیگری وابسته است، همان بخش را هم بخوانید. جداکردن یک قطعه کوتاه بدون شرطهای مرتبط، میتواند معنای آن را عوض کند.
- محاسبه را جدا کنترل کنید: پس از تأیید ورودیها، جمع و تبدیل واحد را با ماشینحساب یا صفحهگسترده بررسی کنید. یک پاسخ خوشخوان، جای کنترل عدد را نمیگیرد.
درخواست پیشنهادی: «از این سند فقط موارد مؤثر بر هزینه را استخراج کن. برای هر مورد، مبلغ یا شرط، تاریخ اعتبار، صفحه یا بخش و عبارت پشتیبان را بیاور. ارجاع به پیوست را مشخص کن. اگر چیزی را پیدا نکردی، بنویس پیدا نشد؛ آن را صفر یا فاقد هزینه فرض نکن. تا تکمیل ورودیها جمع نهایی نساز.»
برای شروع از سند عمومی یا نسخه بینام استفاده کنید. اطلاعات محرمانه مشتری و جزئیات حساب را تنها با مجوز لازم و پس از بررسی شرایط نگهداری داده در ابزار وارد کنید.
برای خرید ابزار، ظرفیت بیشتر را با کدام معیار بسنجیم؟
یک فایل نمونه با پاسخهای از قبل بررسیشده انتخاب کنید؛ ترجیحاً شبیه کار واقعی و بدون اطلاعات محرمانه. ببینید ابزار چند مورد لازم را کامل استخراج میکند، کدام استثنا را جا میاندازد، آیا نشانی منابع درست است و اصلاح خروجی چقدر وقت میگیرد. این یک آزمون شخصی است، نه رتبهبندی عمومی.
پشتیبانی از ورودی بزرگتر وقتی ارزش دارد که محدودیت واقعی کار شما را حل کند. برای خرید اشتراک صرفاً بر اساس عدد ظرفیت تصمیم نگیرید؛ قابلیت بررسی سند فارسی، جدولهای شما و هزینه رسیدن به پاسخ تأییدشده مهمتر از یک عدد تنهاست. برای خدمات مصرفمحور نیز تفاوت هشدار بودجه با سقف هزینه را جدا بررسی کنید.
پرسشهای رایج
اگر مدل شماره صفحه بدهد، پاسخ معتبر است؟
شماره صفحه مسیر بررسی را کوتاه میکند، اما خودش مدرک نیست. صفحه باید واقعاً وجود داشته باشد و متنش همان ادعا را، با شرطها و استثناهای مرتبط، پشتیبانی کند.
آیا بهتر است همیشه فایل را خرد کنیم؟
نه همیشه. بخشبندی میتواند تمرکز را بیشتر کند، اما ممکن است ارتباط یک بند با تعریف یا پیوست را قطع کند. قطعه مرتبط را همراه با زمینه و ارجاعهایش بررسی کنید.
«پیدا نشد» یعنی آن هزینه وجود ندارد؟
خیر. ممکن است سند ناقص، بخش ناخوانا یا جستوجو ناکافی باشد. برای تصمیمی که به نبودن یک هزینه وابسته است، این ابهام باید از اصل سند یا مسئول مربوط برطرف شود.
جمعبندی: ظرفیت بزرگتر دسترسی به اطلاعات بیشتری میدهد؛ اعتماد به نتیجه از کاملبودن شواهد، صحت ارجاعها و تطبیق شرطها میآید. AI میتواند مسیر رسیدن به بند مهم را کوتاه کند، اما پذیرفتن فایل بهتنهایی گواه بررسی کامل آن نیست.